AI 回答复制出来,为什么总带着 ## 和 **
让 AI 列一份周末大扫除清单,屏幕上是整齐的标题、加粗和列表。复制到备忘录里,拿到的却是这样一段:
## 周末大扫除

就 **三件事**:

- 厨房台面
- 阳台
- 衣柜换季
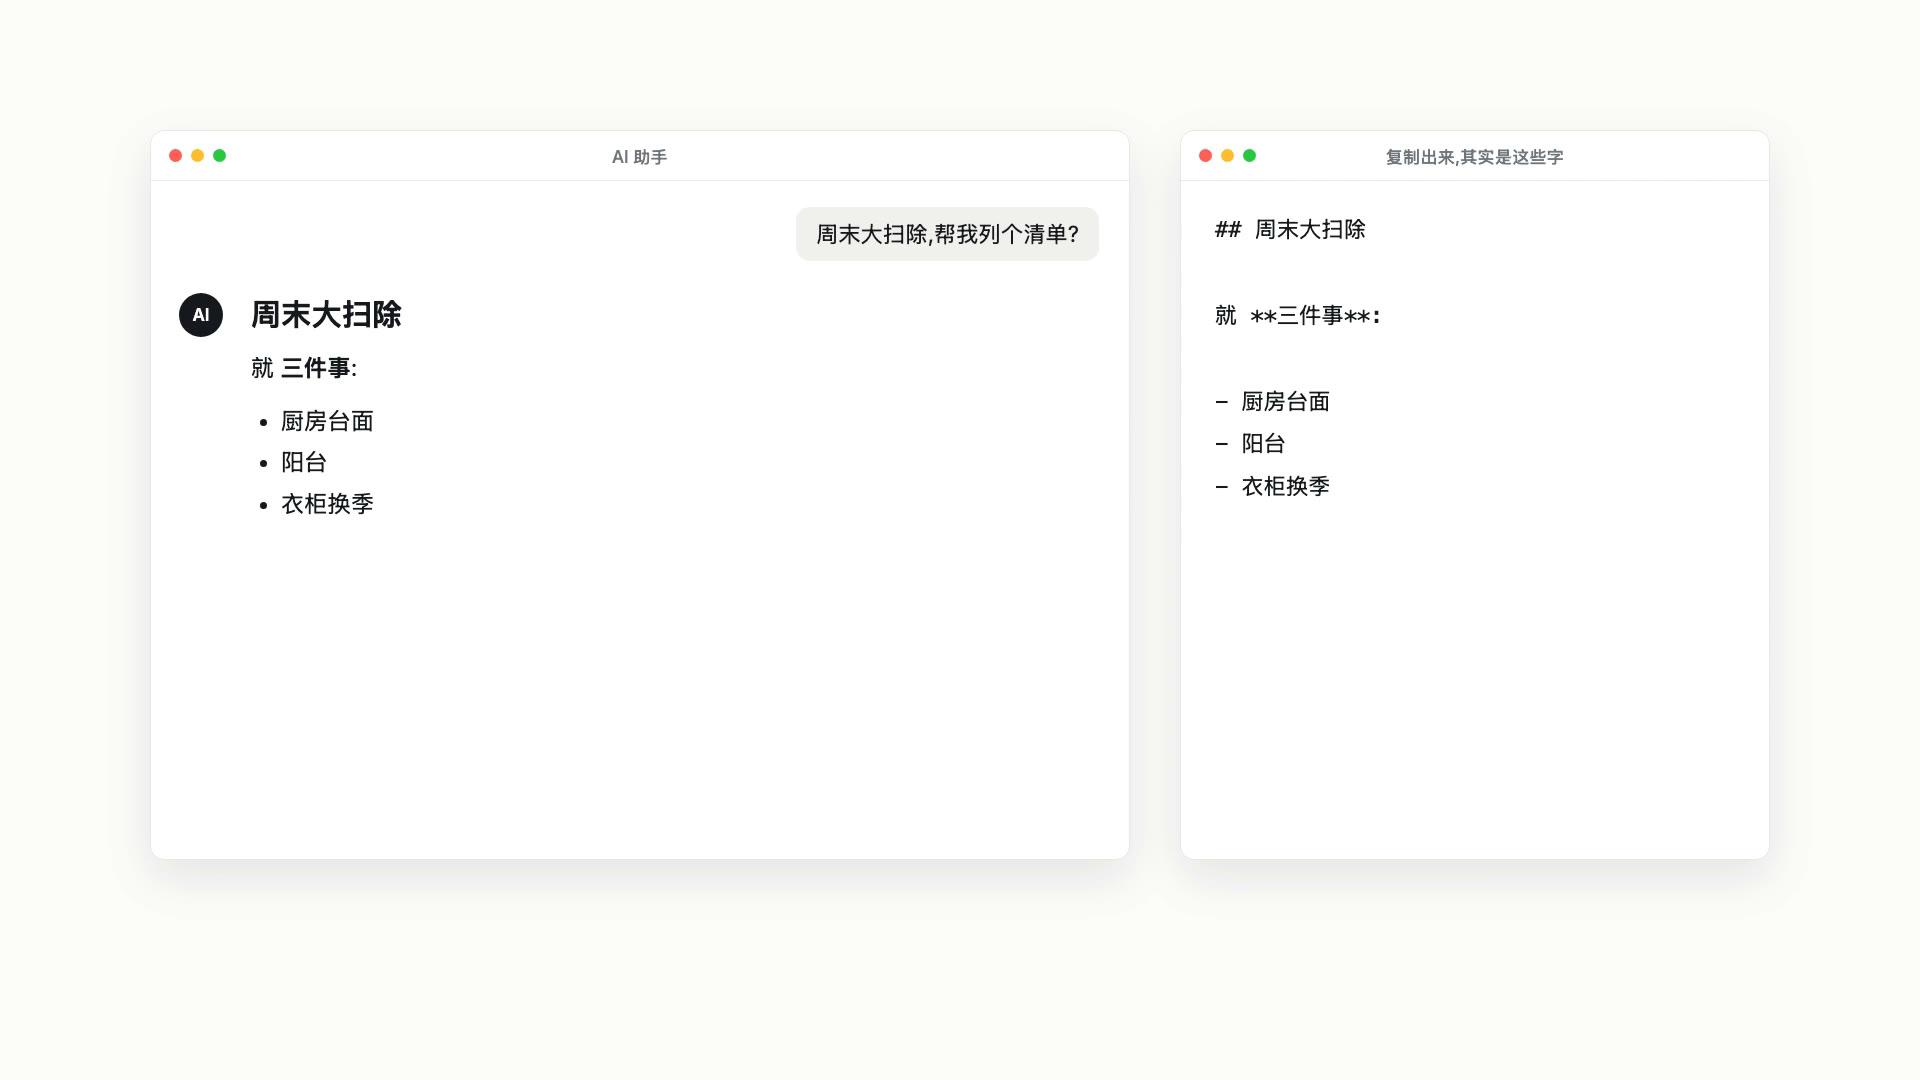
井号、星号、短横线,这些符号就是 Markdown。AI 的回答本来就是用它写的,屏幕上的整齐排版是聊天界面替你渲染出来的。所以你很可能每天都在读 Markdown,只是它通常已经被排好了版。
我们做了一支 87 秒的片子,把这件事演了一遍:在 YouTube 上看。这篇文章是片子的文字版,多讲一点细节。
为什么拿 Word 文档来比
大多数人默认的写作工具是富文本文档:Word、WPS,或者各种在线文档。想让页面好看,就要去调字号、调行距、调缩进,样式和文字粘在一起,写着写着就去折腾工具栏了。
Markdown 走的是另一条路:格式只是几个符号,和文字写在同一行里。
| 你打的字 | 显示出来是 |
|---|---|
# 周末计划 | 一级标题 |
**重要** | 加粗的「重要」 |
- 买菜 | 列表里的一项 |
- [ ] 擦窗户 | 一个可以勾的方框 |
再加上用竖线画的表格,常用的就这么多,十分钟能学完。下面三点,是我们觉得它值得一用的理由。
一、只管写字,更容易进入心流
在 Markdown 里,你需要做的只有那几个符号,剩下的注意力全在内容上。原文本身就能读:没渲染的 **重要**,人一眼看得懂,程序也能直接解析,人和机器读的是同一份东西。
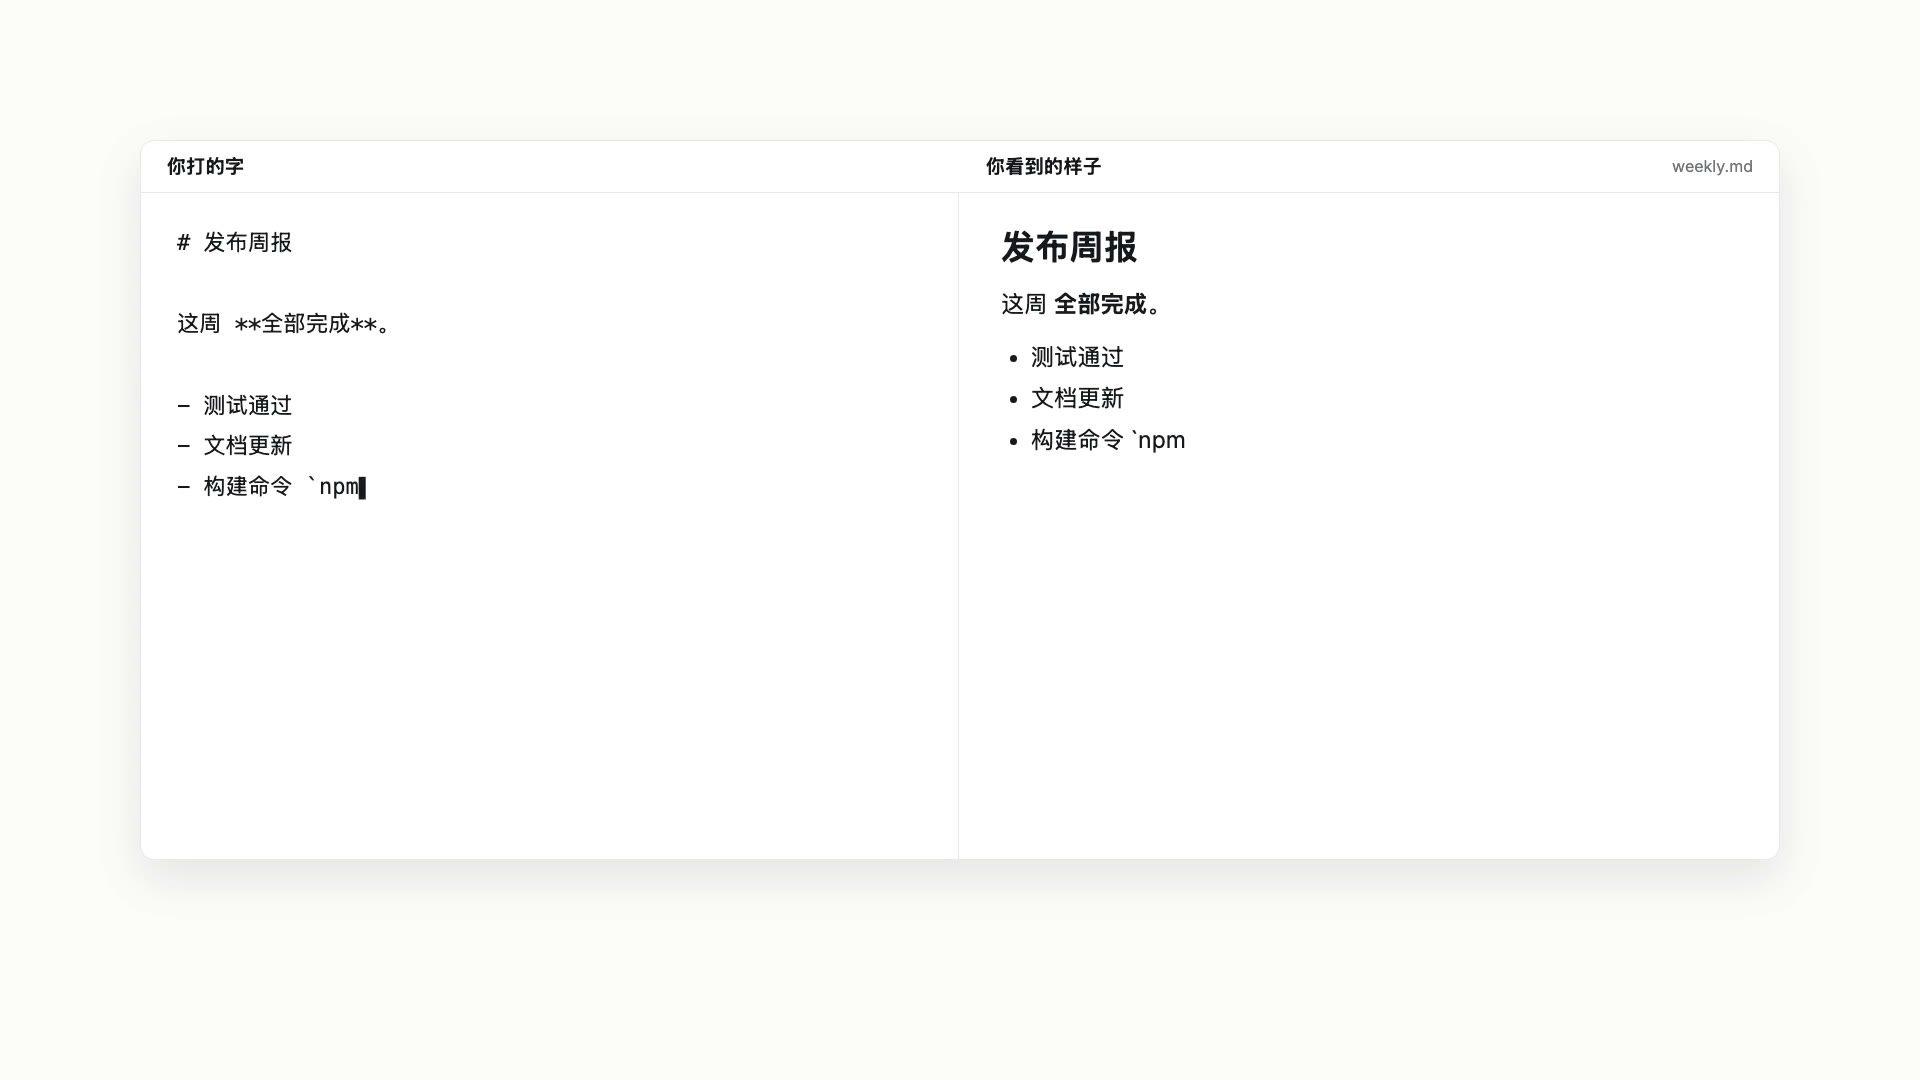
担心对着一堆符号写?现在边写边显示效果的 Markdown 编辑器很普遍,Obsidian、Typora 都是。片子里用的是左右分栏:左边是你打的字,右边同步显示排好版的样子。星号一闭合,那几个字就变成粗体,你不用离开文字去点按钮。
二、接得上 AI 工作流,存得下来
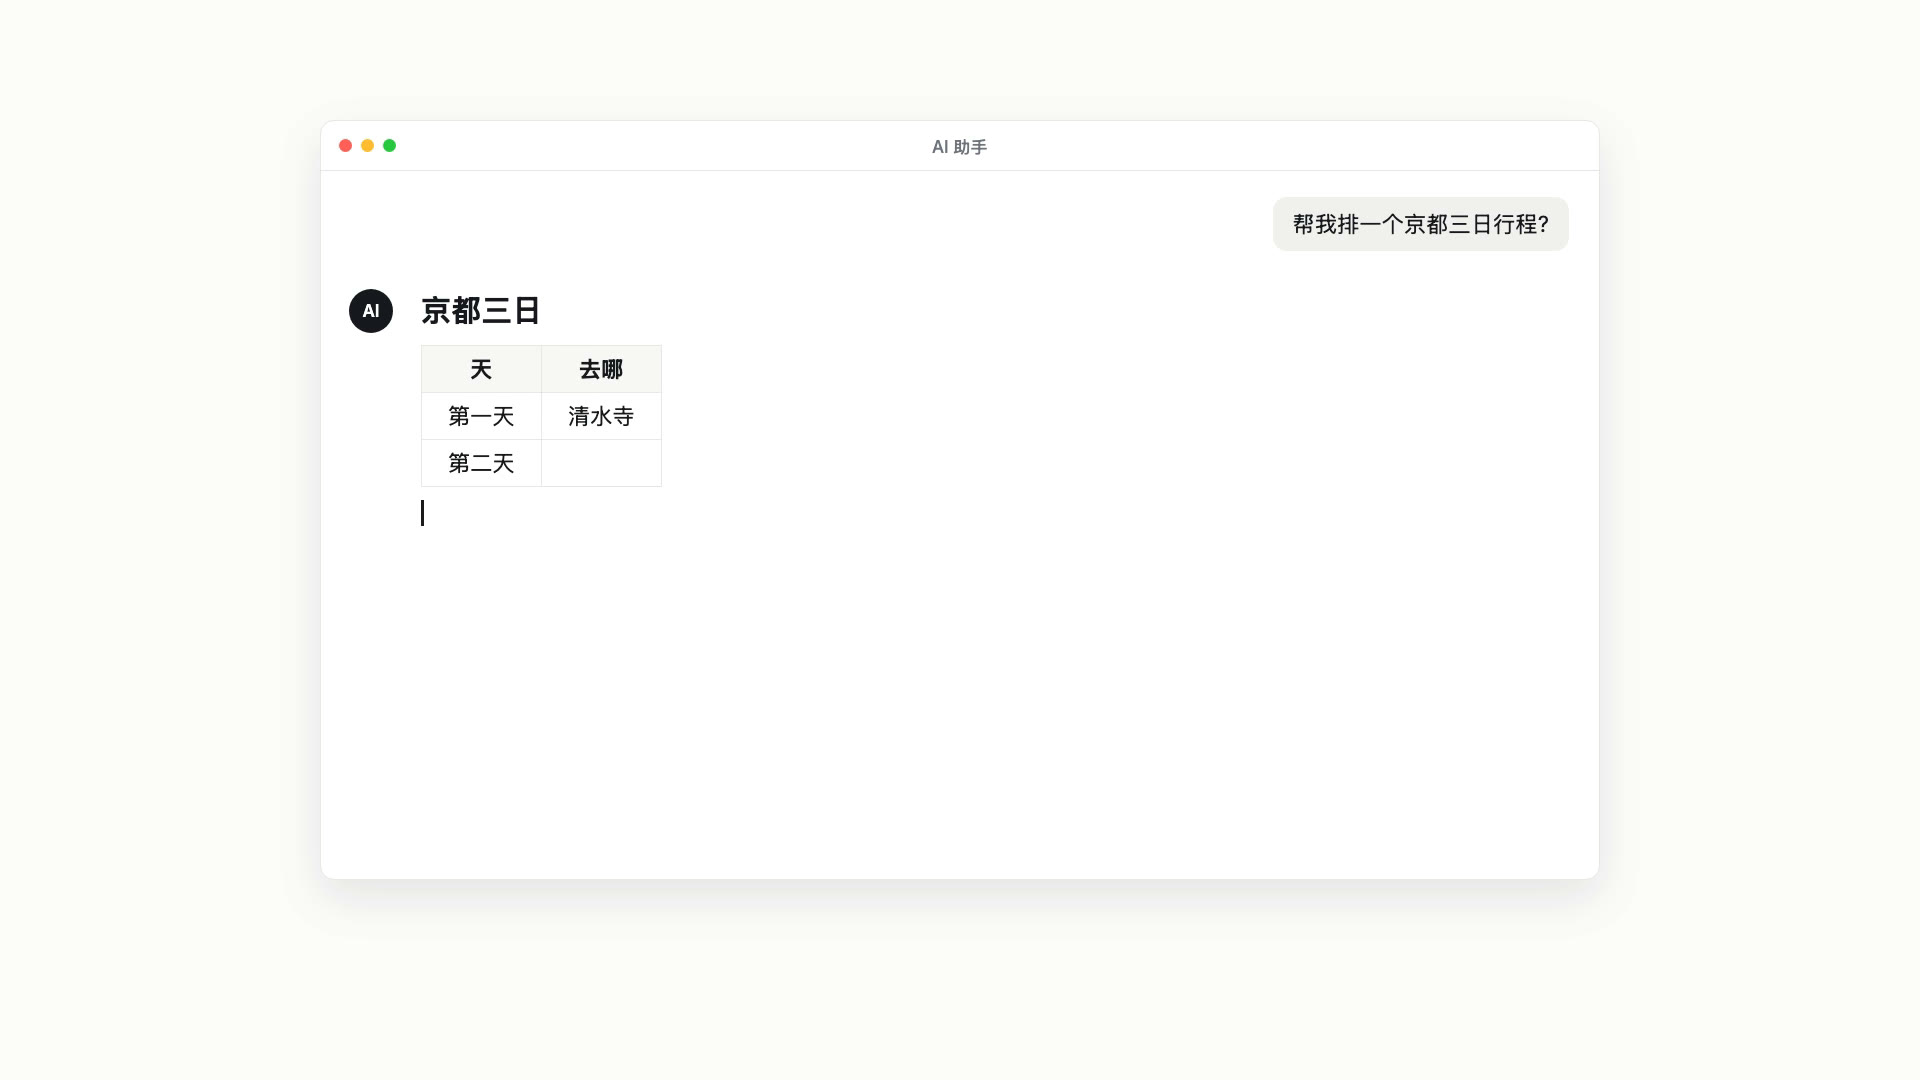
AI 的回答是一个字一个字流出来的,界面一边收一边渲染。片子里有一段京都行程:表格是在字流到一半的时候自己长出来的,因为表头下面那行分隔线一写完,渲染器就认出了「这是一张表」。
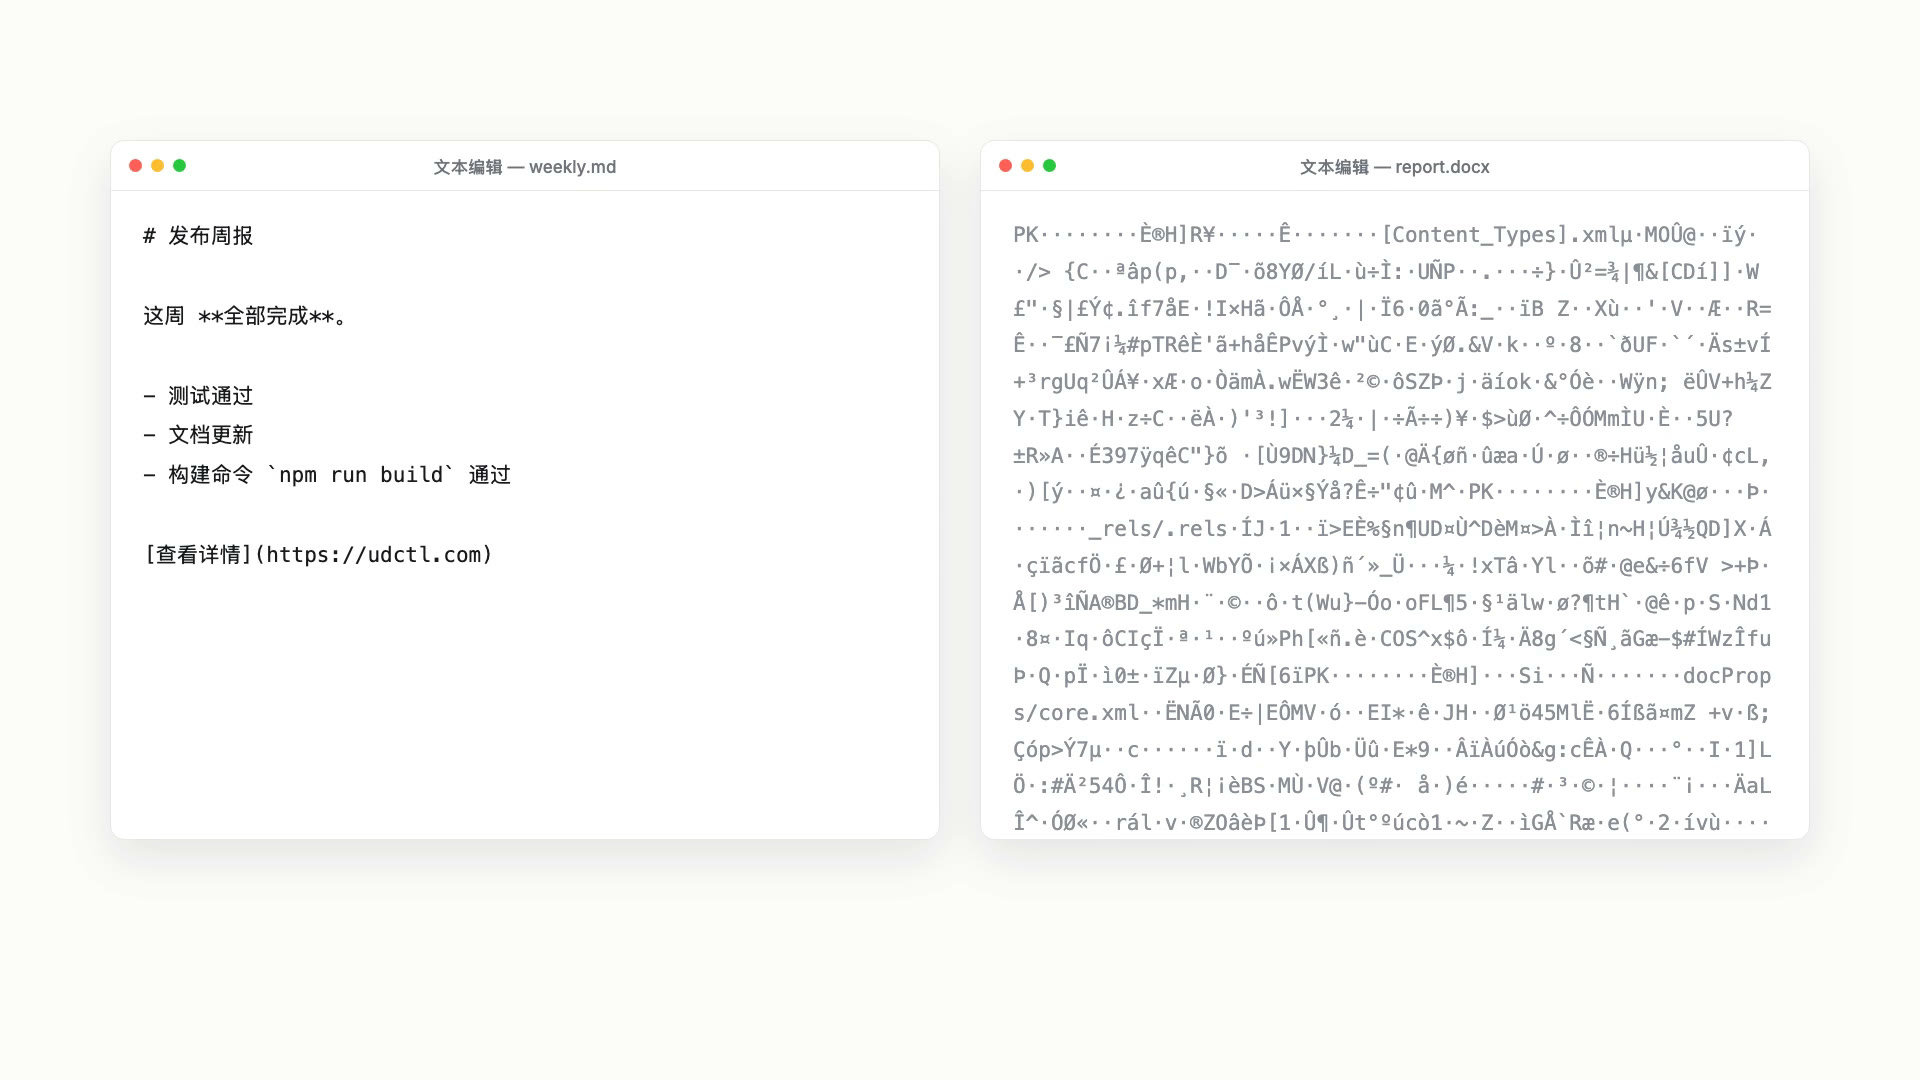
你点「复制」,拿到的是 Markdown 原文。存成一个 .md 文件,用任何 Markdown 阅读器打开,标题、列表、表格都还在,读起来舒服;用最普通的文本编辑器打开,也只是多了几个符号,内容照样读得懂。
换成 .docx 就不一样了。docx 其实是一个压缩包,里面装着 XML 文件。用文本软件直接打开它,看到的是一屏乱码。片子里那屏乱码就是一个真实 docx 文件的原始字节。很多人都遇到过「用错软件打开文件全是乱码」,原因就在这里。
三、作为 AI 时代的基础格式沉淀下来,而不是用完就扔
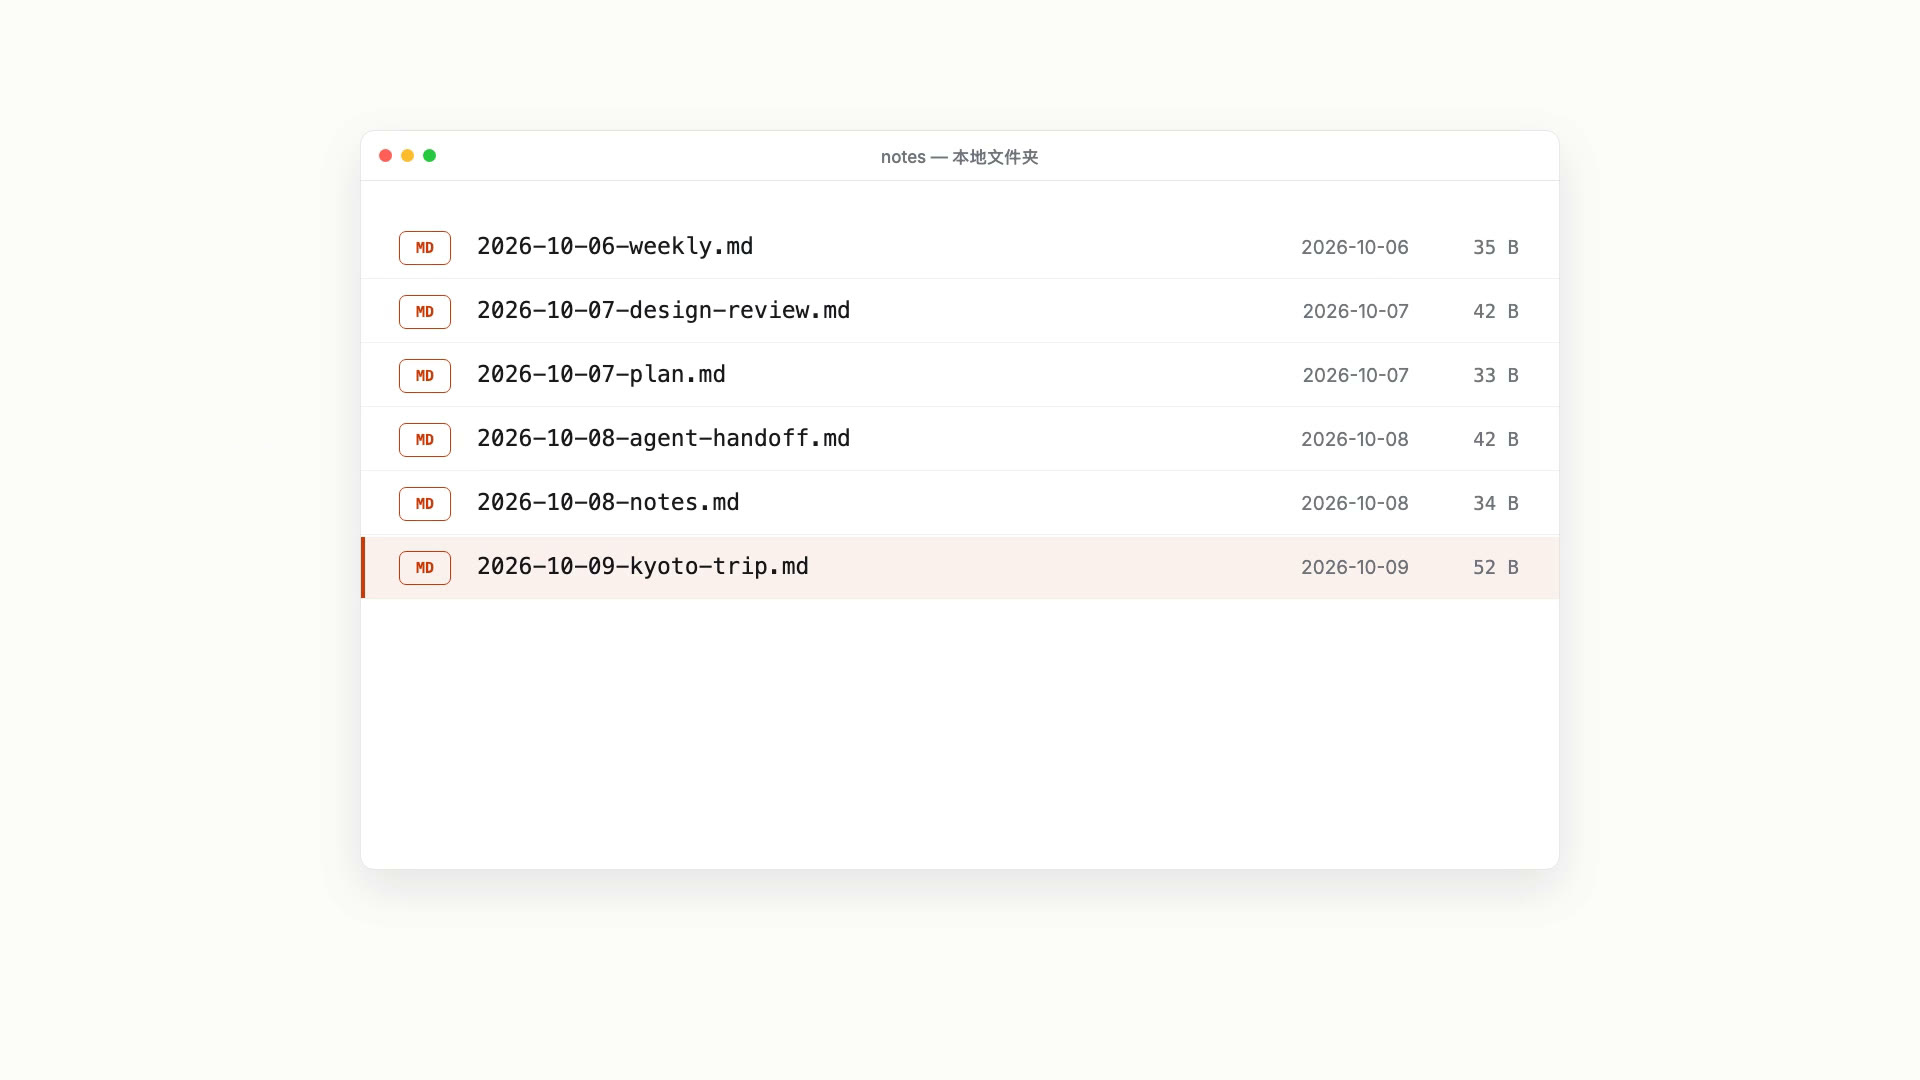
和 AI 聊完,大多数内容就留在了聊天记录里,过几天就找不到了。如果每次有用的回答都存成一个带日期的 .md 文件,一个文件夹里就会慢慢攒起行程、清单、读书笔记、工作记录。它们都是纯文本,以后换什么软件都打得开。
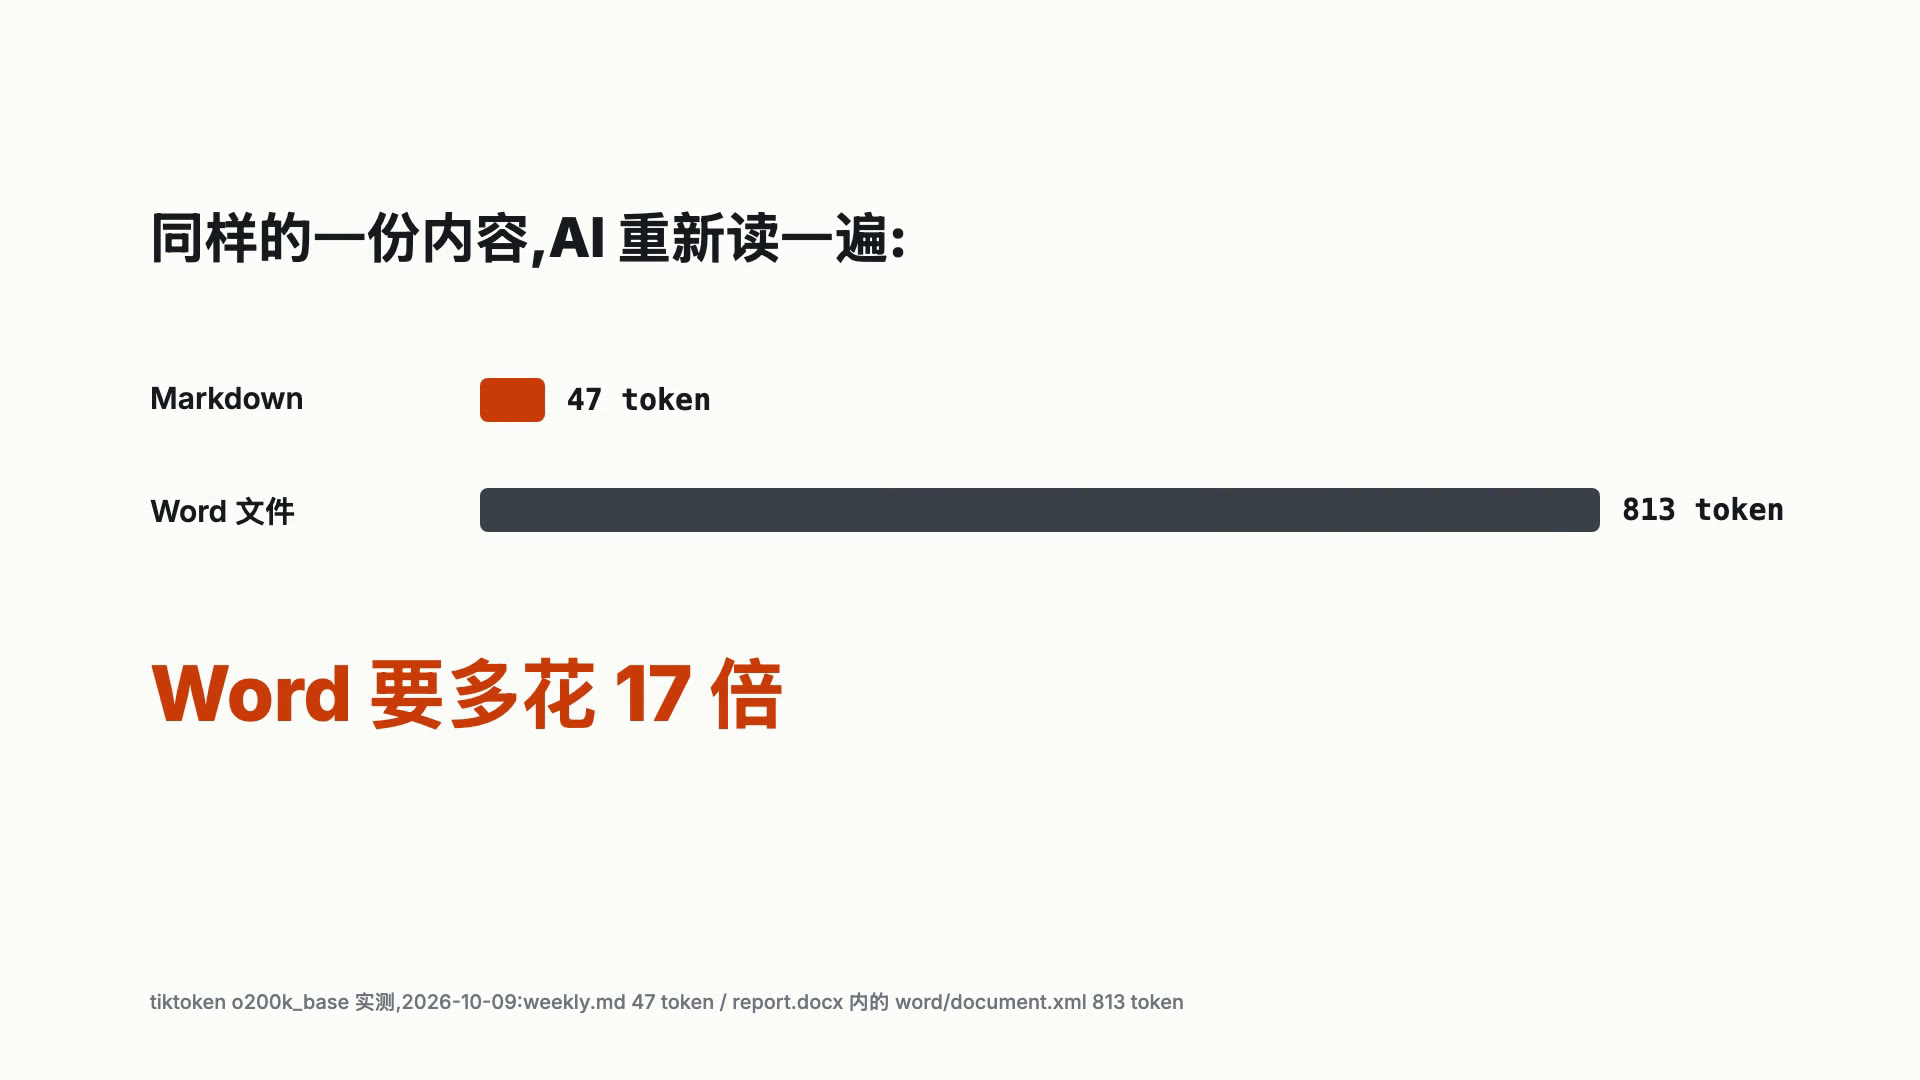
纯文本对 AI 也更省。我们拿片子里那份文档实测了 token 数(工具是 tiktoken,编码 o200k_base):Markdown 版 47 个 token;同样内容存成 docx,光是里面放正文的那个 XML 文件(word/document.xml)就要 813 个,差了 17 倍左右。这只是一份样本文档的读数,不同文档比例会不一样,但方向是一致的:你攒下来的东西,AI 每次读一遍,都按 token 算。
udctl 里也是 Markdown
udctl(UnDercontrol)的任务正文和笔记都是 Markdown,同一个编辑器也用在记账、账户这些需要写字的地方。你写下的内容是纯文本,Claude Code、Codex、OpenCode 或任何终端里的 agent 都能通过 ud 命令行直接读写,不需要先转换格式。
探索、记录、沉淀。人与 AI agent 共用的私密工作空间。udctl.com